AI-hallucinationer: Sådan kontrollerer I svarene
Et overbevisende svar kan være forkert. Få en praktisk metode til kildekontrol, testopgaver og menneskelig godkendelse — med et konkret produktdata-eksempel.
Partner & CTO hos Adtention
Hvad er en AI-hallucination?
En AI-hallucination er et svar, som præsenterer forkerte eller opdigtede oplysninger som troværdige. Det kan være en produktegenskab, der ikke findes i materialet, et citat uden en virkelig kilde eller et svar, der modsiger det dokument, modellen skulle arbejde med.
Det amerikanske standardinstitut NIST beskriver fænomenet som confabulation i sin risikoprofil for generativ AI. Det centrale for virksomheden er, at en sikker formulering ikke beviser, at indholdet er korrekt. Kvalitet skal vurderes mod opgaven og dens grundlag.
Et produktdata-eksempel: Tre påstande, to problemer
Her er en konstrueret øvelse, som viser, hvordan I kan gennemgå et AI-udkast. Det er ikke et output fra en dokumenteret modeltest eller en kundecase.
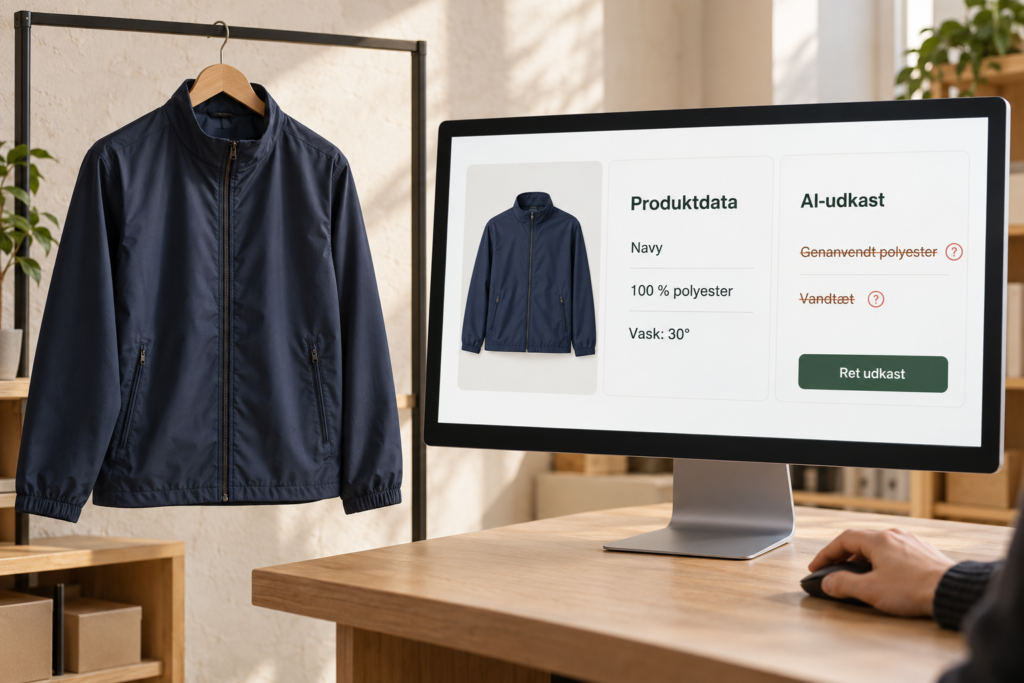
Godkendt produktgrundlag: Jakke model A. Farve: navy. Materiale: 100 % polyester. Vaskeanvisning: 30 grader. Der er ingen oplysninger om vandtæthed, genanvendt materiale eller produktionsland.
Forestil jer dette fejlbehæftede udkast: “En navy jakke i genanvendt polyester, der holder dig tør på regnvejrsdage.” Teksten er flydende, men den går længere end grundlaget:
| Påstand i udkastet | Kontrol mod grundlaget | Handling |
|---|---|---|
| Navy jakke | Farven er oplyst | Kan beholdes |
| Genanvendt polyester | Kun polyester er oplyst | Fjern “genanvendt” |
| Holder dig tør i regn | Ingen dokumentation for vandtæthed | Fjern eller indhent dokumentation |
Et korrigeret udkast kan være: “Jakke model A i navy og 100 % polyester. Kan vaskes ved 30 grader.” Det er mindre farverigt, men holder sig til materialet. Ønsker I flere salgsargumenter, er næste skridt at skaffe et bedre produktgrundlag — ikke at få modellen til at formulere sig mere sikkert.
Find ud af, hvor fejlen opstår
Et forkert svar er ikke altid et spørgsmål om en dårlig prompt. Undersøg hele forløbet, før I ændrer instruktionen:
- Kilden: Er oplysningerne forældede, mangelfulde eller indbyrdes modstridende?
- Opslaget: Fik løsningen det rigtige dokument og den relevante version?
- Fortolkningen: Er en undtagelse, en enhed eller et forbehold blevet overset?
- Formuleringen: Har modellen tilføjet noget, der ikke følger af kilden?
- Systemhandlingen: Svarer teksten til det, der faktisk blev registreret eller sendt?
Hvis et svar bygger på sidste års prisliste, hjælper det ikke nødvendigvis at bede AI om at “være mere præcis”. Hvis en assistent skriver, at en ordre er opdateret, skal ændringen kontrolleres i ordresystemet. Et velformuleret svar er ikke en kvittering for en gennemført handling.
Byg et lille testsæt med forskellige opgaver
Start med de opgaver, som løsningen faktisk skal hjælpe med. Skriv det acceptable resultat eller bedømmelseskriterierne ned, før I vurderer svaret. Lad en fagperson, der kender opgaven, være med til at definere dem.
| Testtype | Eksempel | Det skal I se efter |
|---|---|---|
| Normal opgave | Alle produktfelter findes | Fakta og obligatoriske oplysninger bevares |
| Manglende oplysning | Vandtæthed er ikke oplyst | Løsningen opfinder ikke en egenskab |
| Modstridende kilder | To dokumenter har forskellig leveringstid | Konflikten bliver synlig og håndteres efter en aftalt regel |
| Spørgsmål uden for opgaven | Kunden spørger til en særlig rabataftale | En person med mandat overtager |
| Fejl i et system | Opslaget i produktdatabasen fejler | Løsningen melder fejl frem for at påstå, at opslaget lykkedes |
Brug nogle eksempler til at forbedre løsningen og andre til den afsluttende kontrol. Ellers risikerer I kun at se, om den kan genkende de opgaver, I allerede har tilpasset den til. Gentag relevante testopgaver, når variation i svarene har betydning. Et lille testsæt finder problemer; det dokumenterer ikke i sig selv en bestemt fejlprocent i hele driften.
Vurdér fejl efter konsekvens
En forkert tone og en forkert pris bør ikke tælle som samme slags fejl. Lav få, tydelige kategorier: brugbart, kræver rettelse og kritisk fejl. Beskriv, hvad kategorierne betyder for netop jeres opgave.
Som eksempel kan en lidt lang formulering være en rettelse, mens en opdigtet certificering skal stoppe publiceringen. Hvis ét svar indeholder begge dele, må et højt gennemsnit for sproglig kvalitet ikke skjule den kritiske fejl. Registrér også tiden, som kontrollen tager. Kvalitet og samlet arbejdsindsats skal vurderes sammen.
Hvorfor er “er du sikker?” ikke nok?
At bede modellen kontrollere sit eget svar kan give et nyt forslag. Det skaber ikke et uafhængigt bevis. Gå til originalkilden: findes dokumentet, understøtter det påstanden, og gælder oplysningen i den konkrete situation? En kildehenvisning skal kontrolleres på indholdet, ikke kun på om linket kan åbnes.
En automatisk kvalitetskontrol kan hjælpe med at finde afvigelser, men også den skal afprøves. Sammenlign dens vurderinger med fagpersoners vurderinger på konkrete eksempler. Alexandra Instituttets arbejde med kvalitetssikring af AI viser blandt andet forskellen mellem påstandsverifikation, mønstersøgning og andre kontrolmetoder.
Gør godkendelsen til en del af arbejdet
Aftal, hvem der må godkende, hvad der skal sendes videre til en fagperson, og hvornår løsningen skal stoppes. Den ansvarlige skal have adgang til kilden og tid til at undersøge den. En godkendelsesknap uden et brugbart grundlag er en svag kontrol.
Brug fejlene til at forbedre kilder, opslag, instruktioner eller arbejdsgang, og test ændringen igen. Vores tilgang til AI-implementering forbinder afprøvning, oplæring og ansvar. Vil I træne medarbejdernes daglige vurdering, kan I også læse om praktisk AI-oplæring og bruge vores guide til gode AI-prompts. Læs desuden om RAG og egne kilder og datakvalitet, hvis problemet ligger i grundlaget for svarene.